Buzz 为每个人创造自己的web3 Agent
1. Buzz的架构如下:
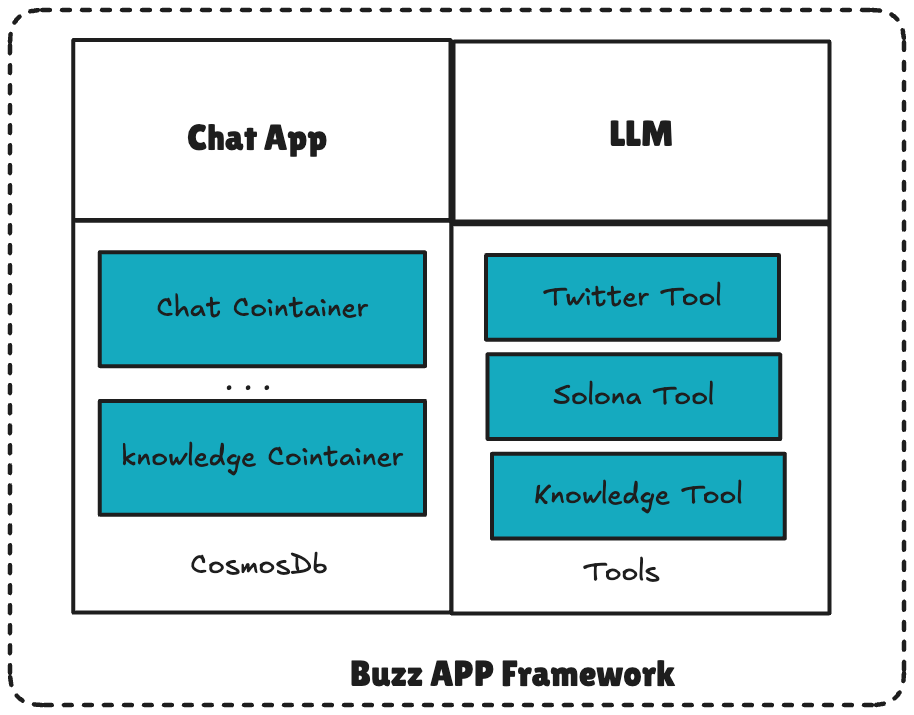
Buzz基本上还是跟我们写过的ElizaOS框架差不多的架构,分为 Chat App, LLM, Tools, CosmosDB.
- ChatApp 就是我们登陆 Buzz 时的用户界面,主要用于管理跟用户的交互过程
- LLM 仍然是任何Agent的核心组件就不多介绍了
- Buzz 目前支持的 tool 主要有 Twitter Tools, Solona Tools, Knowledge Tools
- 其中Twitter Tools实现了通过用户给的keyword 在推特上搜索信息并且总结后返回给用户
- Solana Toos 则是实现了一些Defi协议的操作,例如swap, stake 等待操作
- Knowledge Tools 则是Buzz 的特色,它预先往自己的数据库添加了一些web3的知识,主要是solona上defi 协议的相关知识,因此当用户询问跟这些知识相关的问题时会触发
- CosmosDB 则类似于我们之前 ElizaOS 文章里的 memory ,用于记录一些数据,在Buzz中memory被划分成两个分区,一个分区记录跟不同用户的聊天历史,一个分区记录一些web3的公共知识,不同的用户可以同时使用这部分知识。
2. 完整流程
2.1 调用推特Twitter Tool流程
接下来我们来看下 Buzz的完整流程:
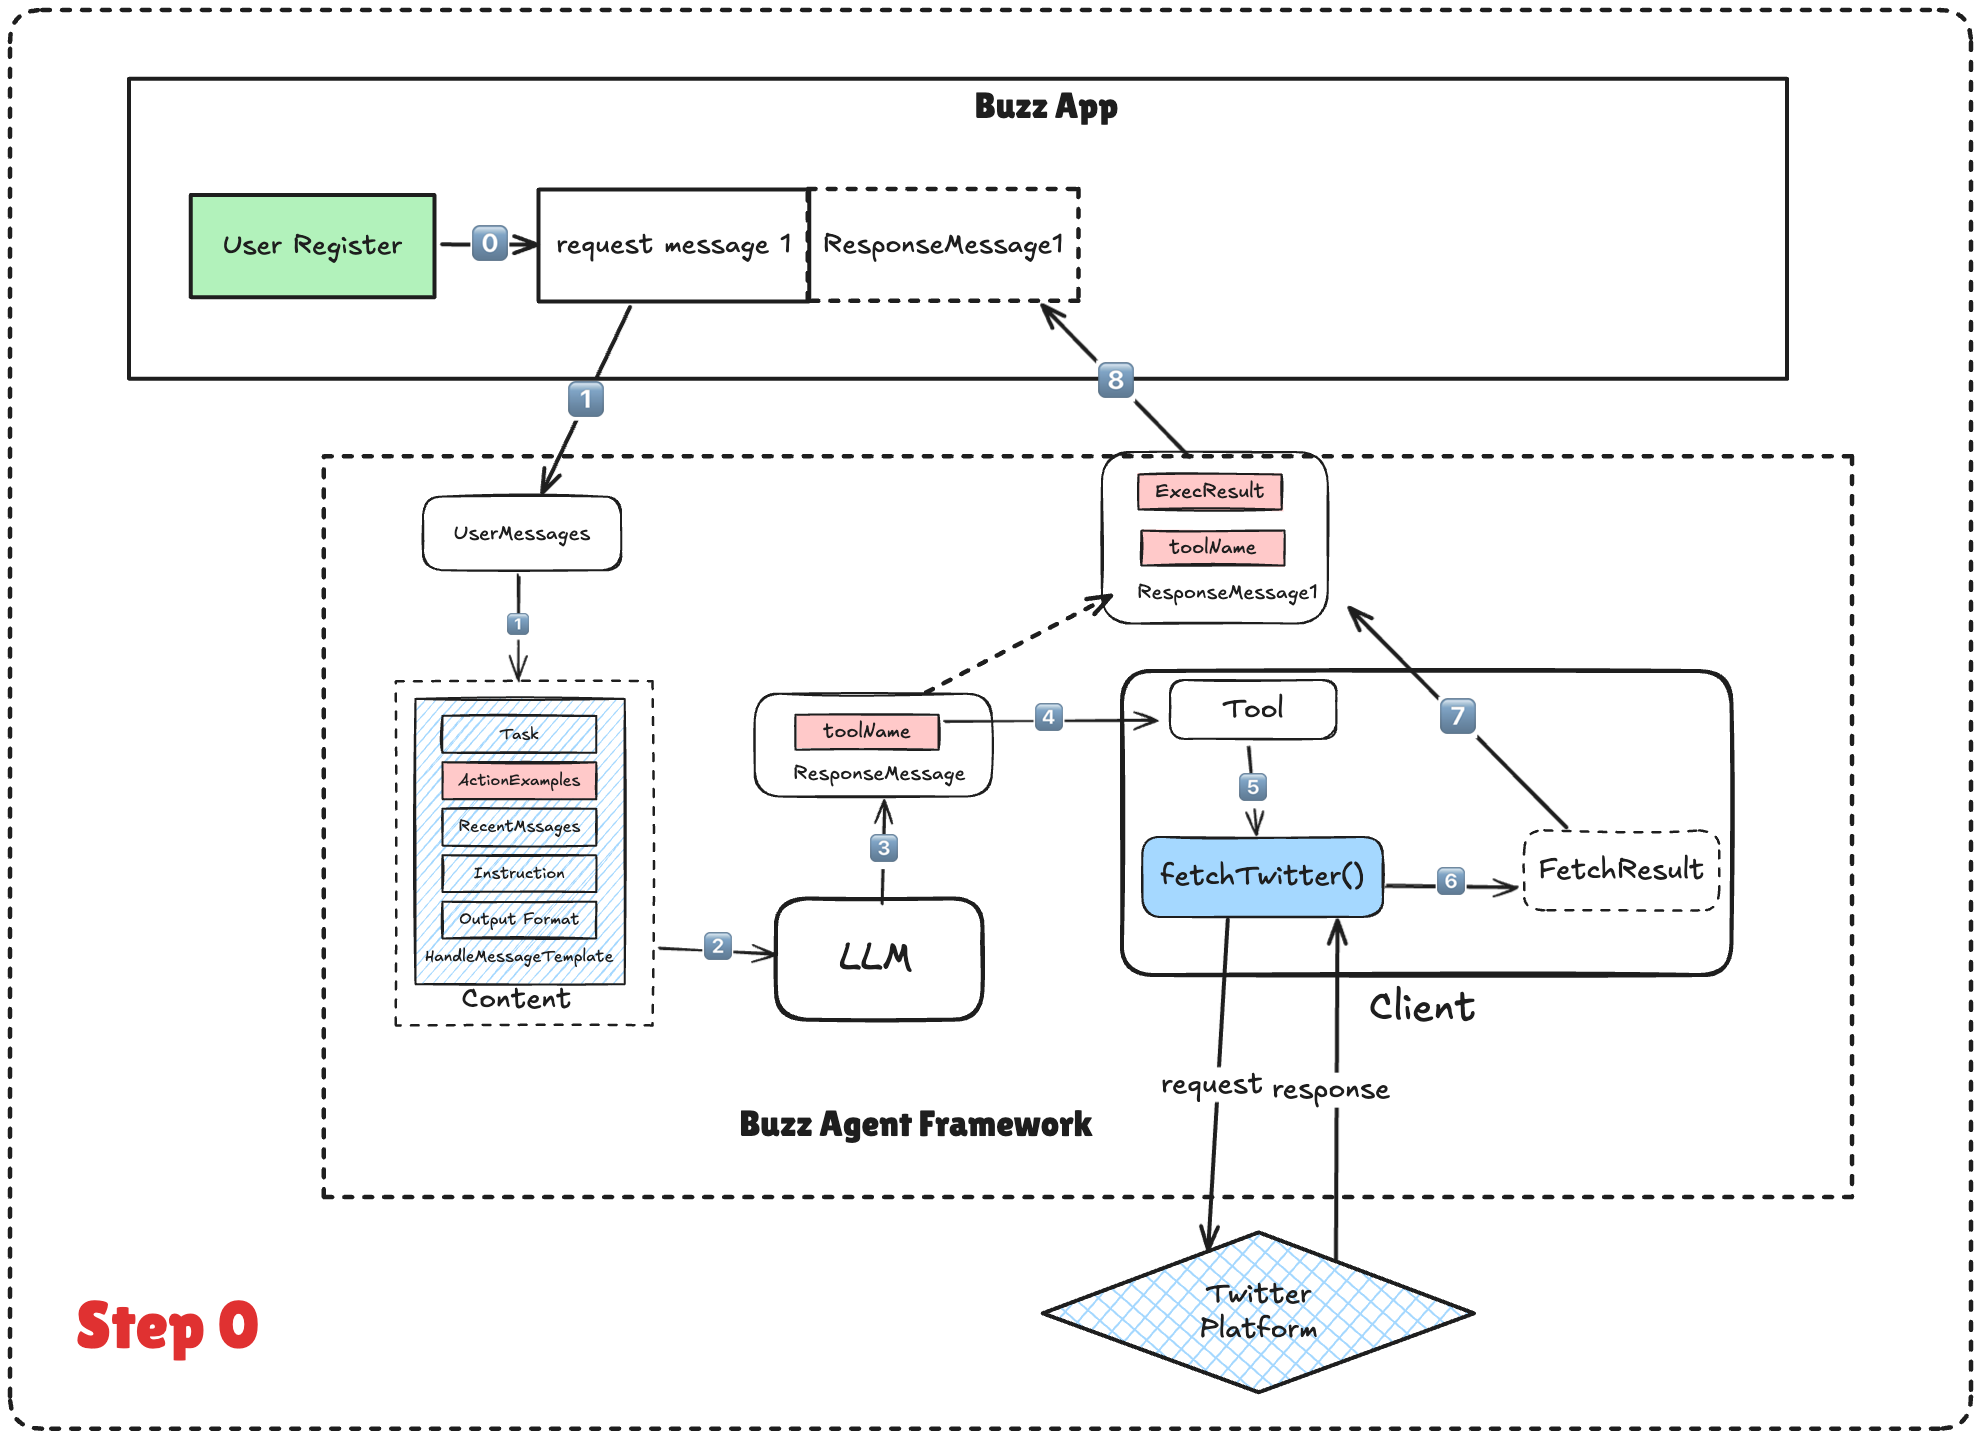
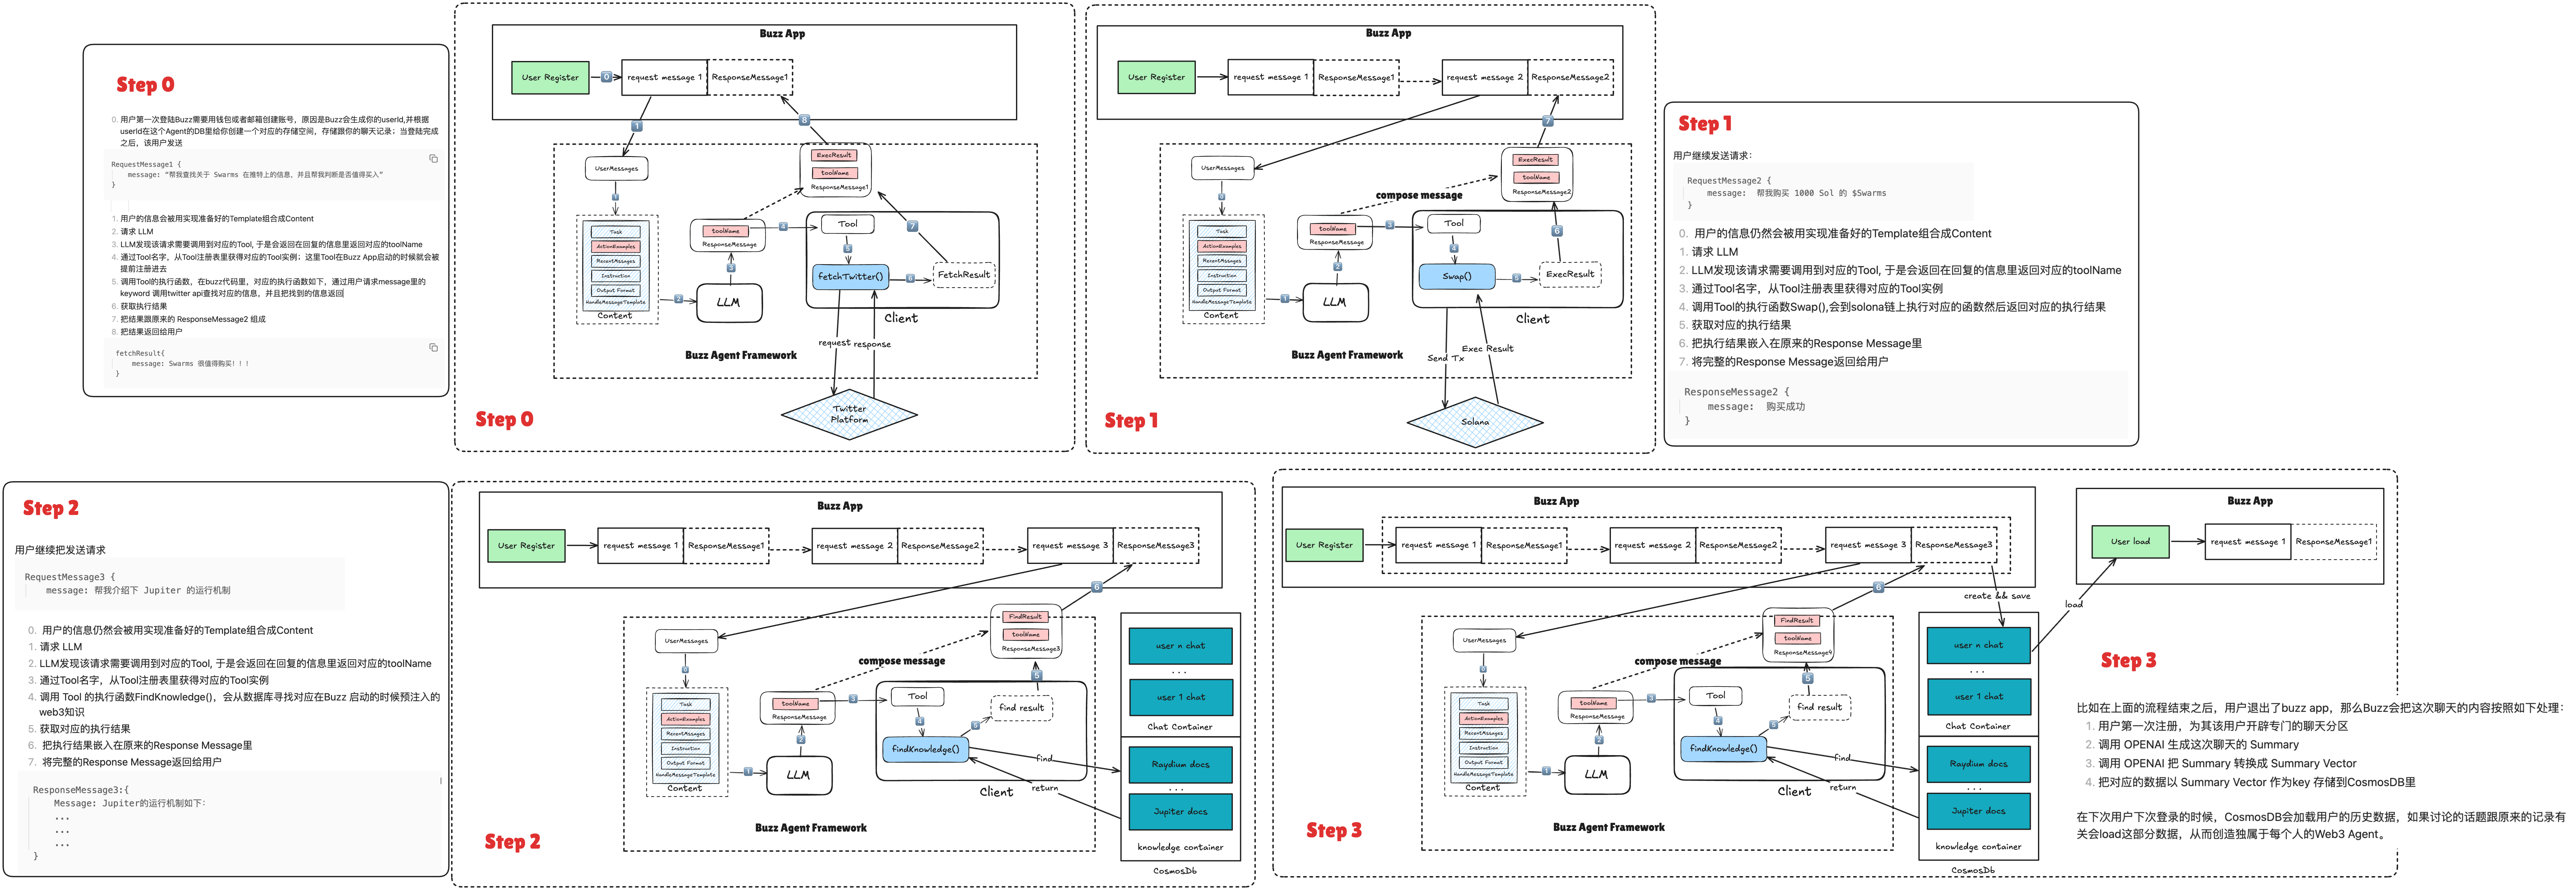
- 用户第一次登陆Buzz需要用钱包或者邮箱创建账号,原因是Buzz会生成你的userId,并根据userId在这个Agent的DB里给你创建一个对应的存储空间,存储跟你的聊天记录;当登陆完成之后,该用户发送
RequestMessage1 { message: "帮我查找关于 Swarms 在推特上的信息,并且帮我判断是否值得买入" } - 用户的信息会被用实现准备好的Template组合成Content
- 请求 LLM
- LLM发现该请求需要调用到对应的Tool, 于是会返回在回复的信息里返回对应的toolName
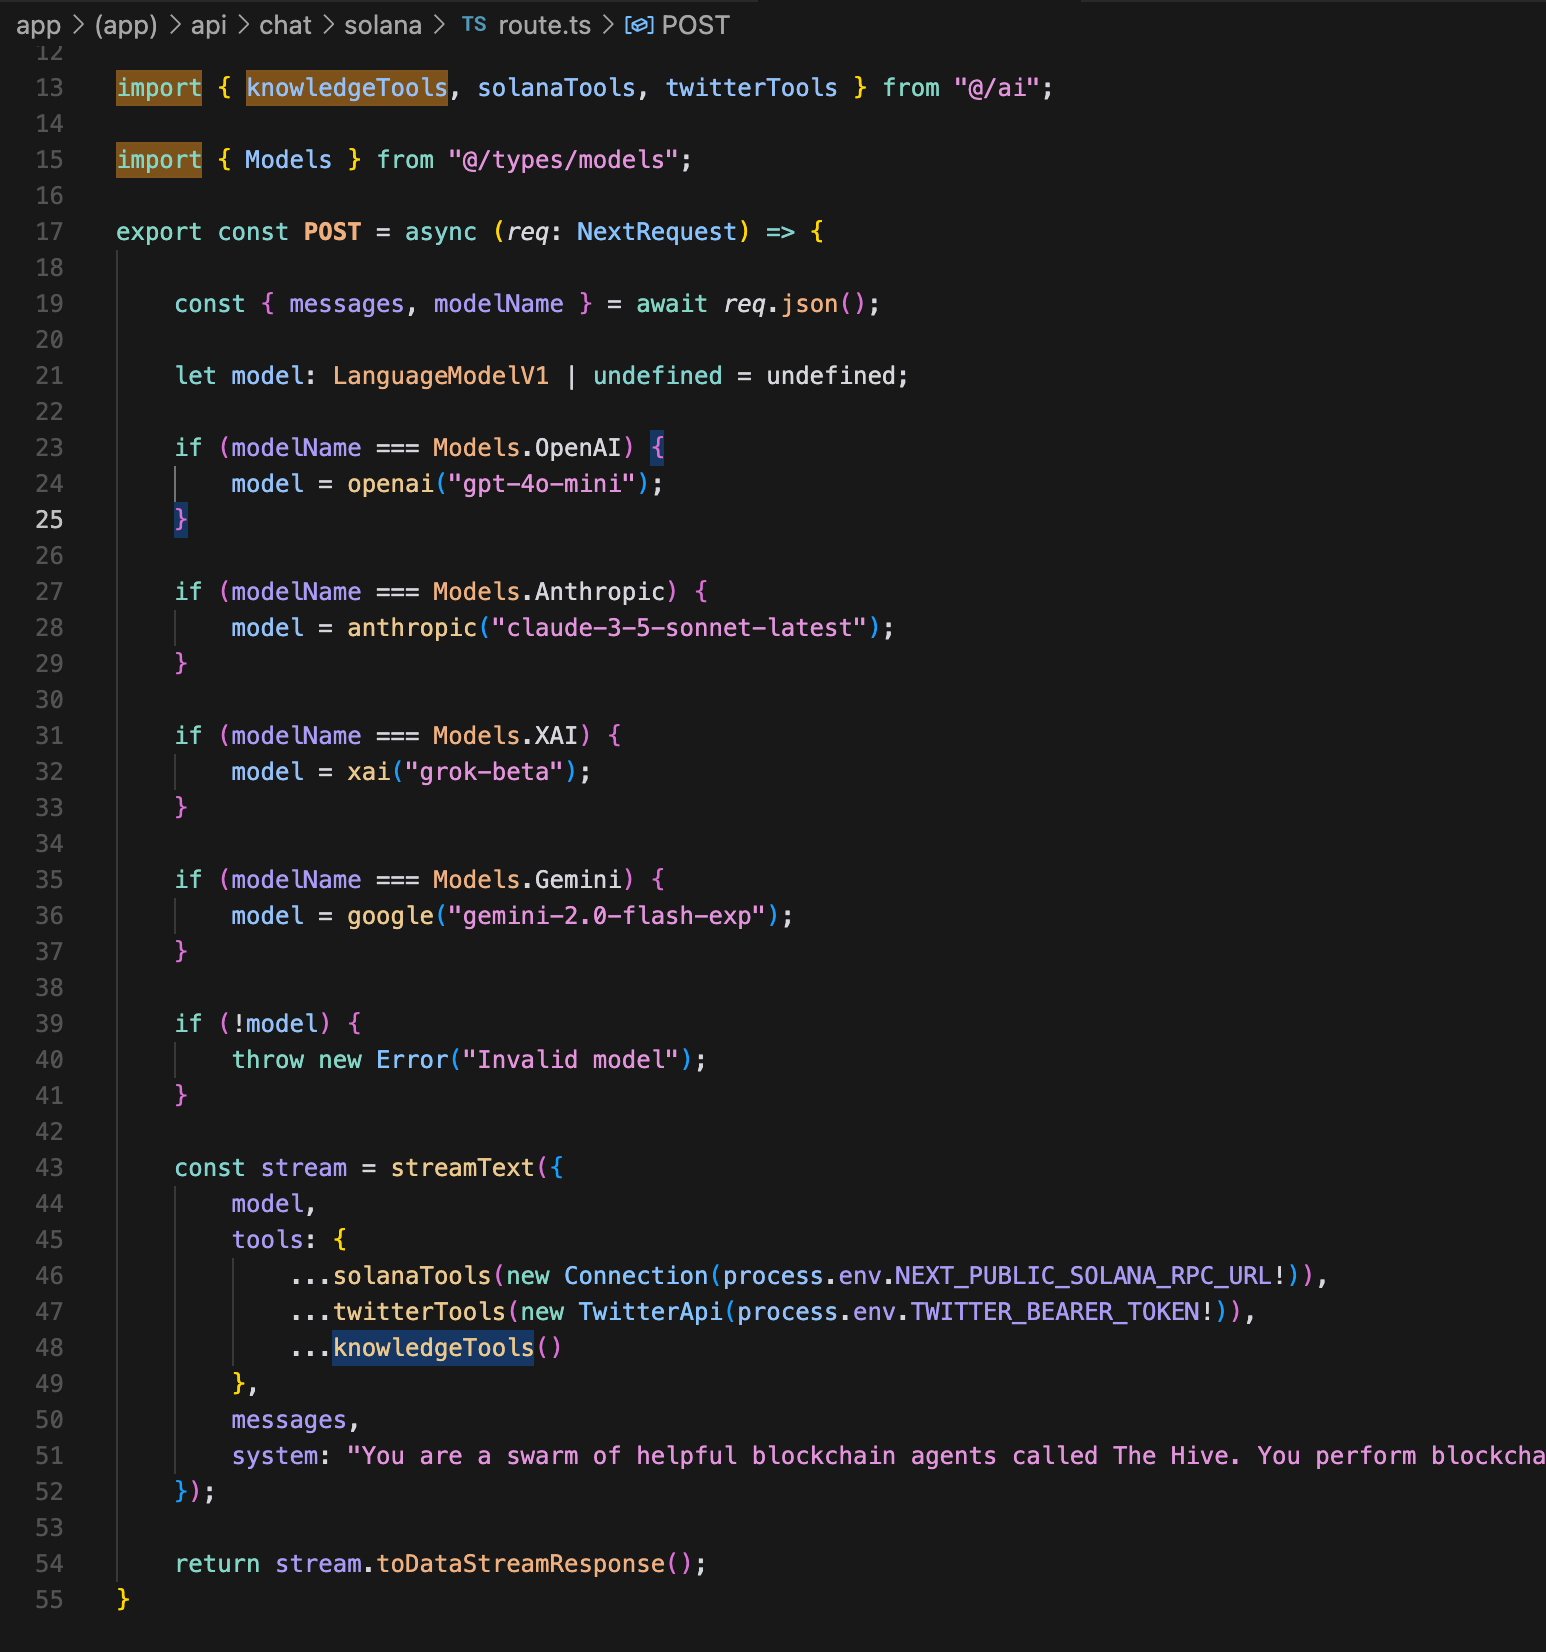
- 通过Tool名字,从Tool注册表里获得对应的Tool实例;这里Tool在Buzz App启动的时候就会被提前注册进去,如下代码:
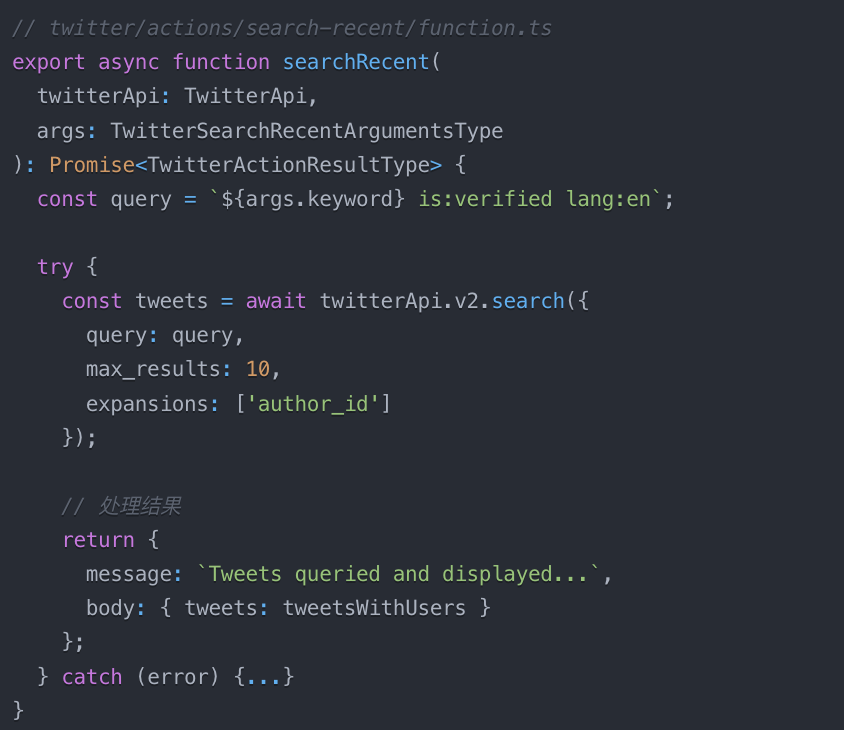
- 调用Tool的执行函数,在buzz代码里,对应的执行函数如下,通过用户请求message里的keyword 调用twitter api查找对应的信息,并且把找到的信息返回
- 获取执行结果
- 把结果跟原来的 ResponseMessage2 组成
- 把结果返回给用户
 fetchResult{
 message: Swarms 很值得购买!!!
 }
2.2 调用Solona Tool流程
用户继续发送请求:
 RequestMessage2 {
	 message:  帮我购买 1000 Sol 的 $Swarms
 }
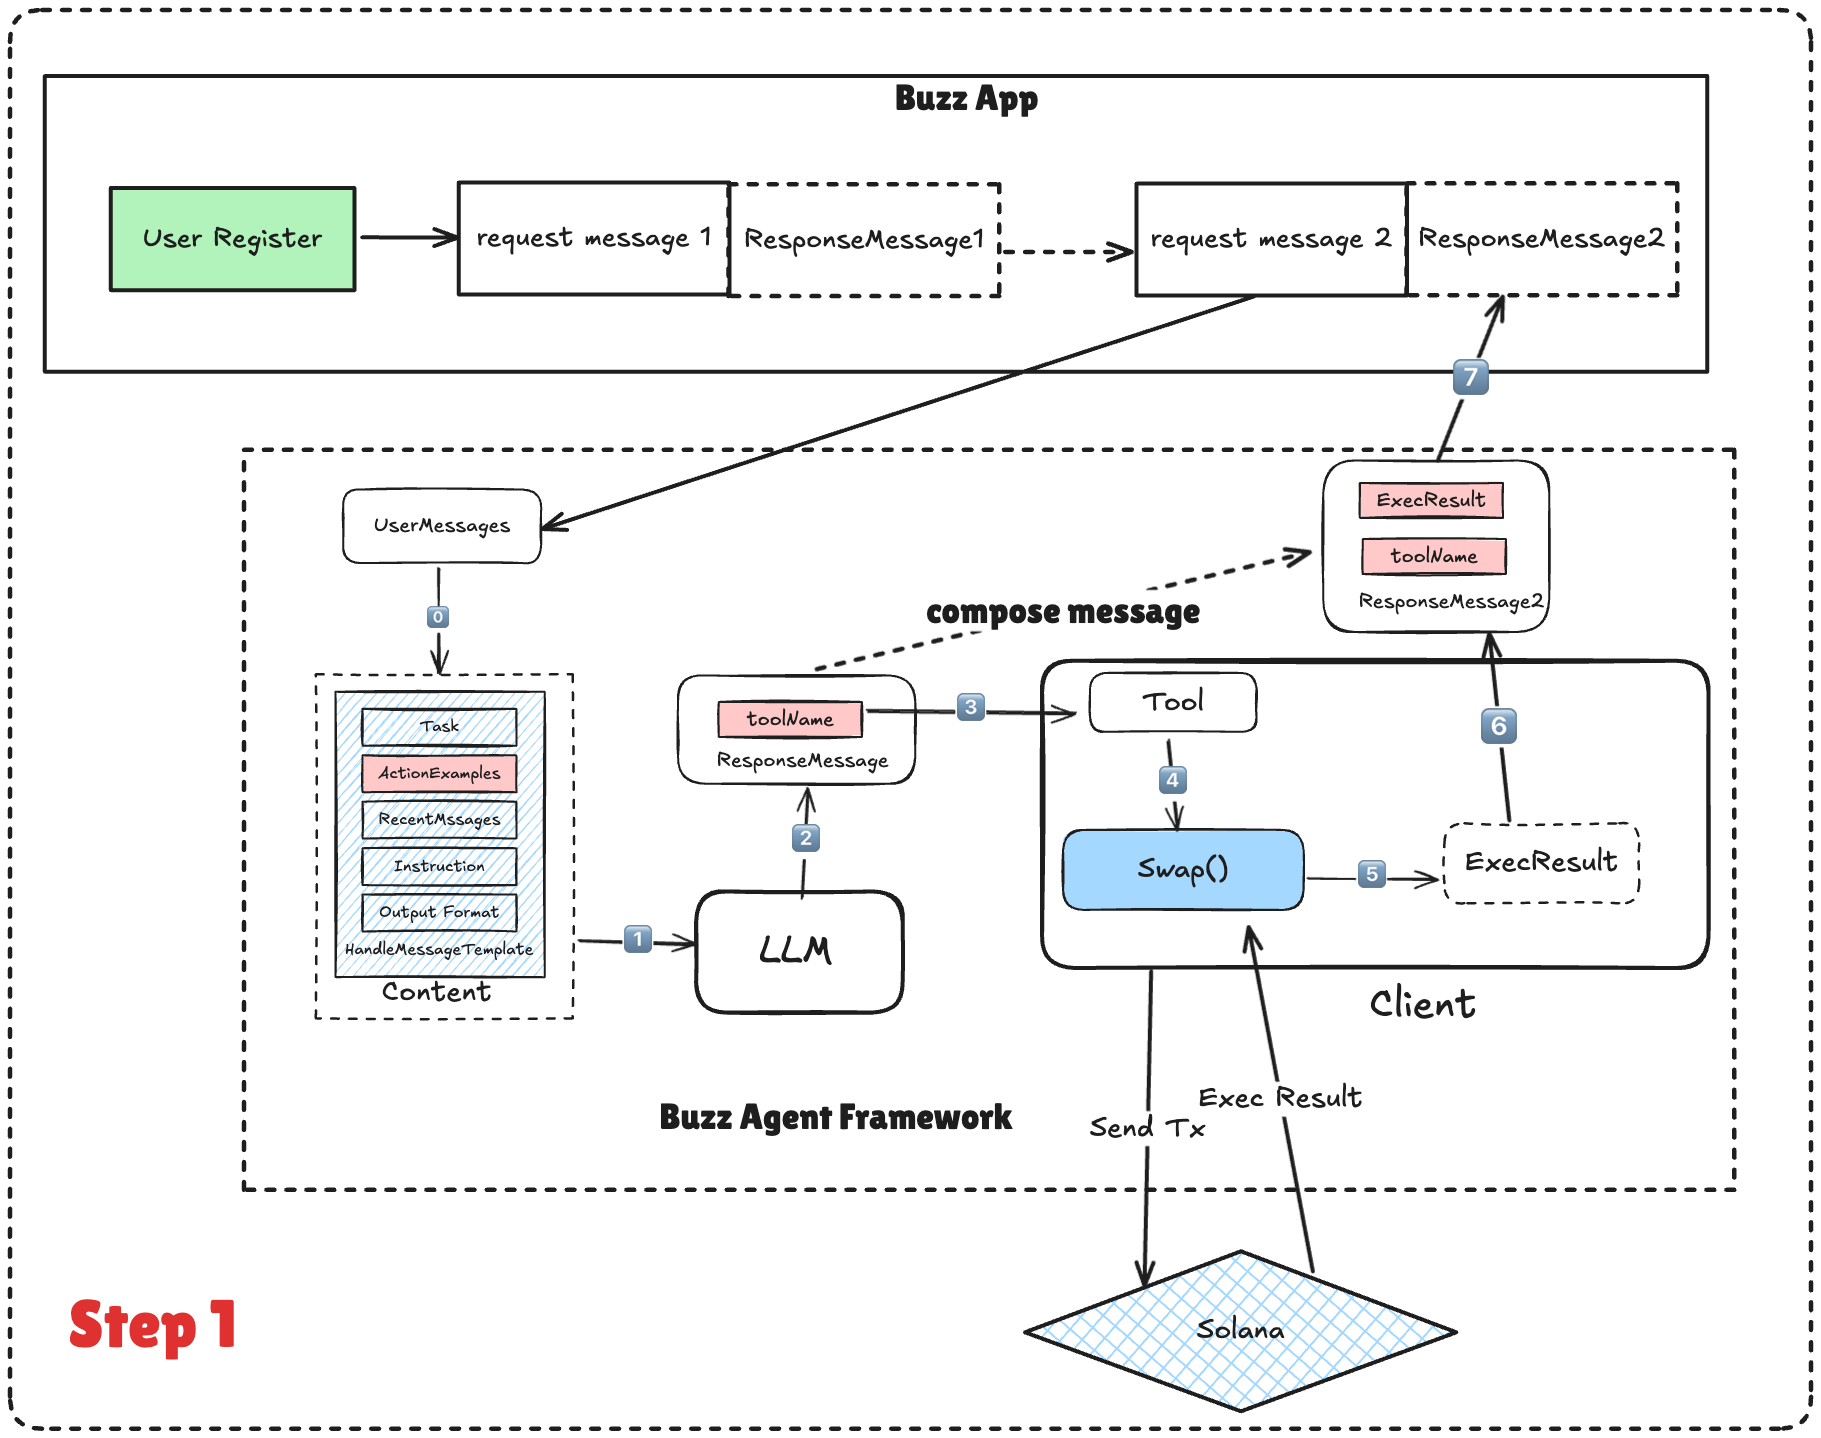
- 用户的信息仍然会被用实现准备好的Template组合成Content
- 请求 LLM
- LLM发现该请求需要调用到对应的Tool, 于是会返回在回复的信息里返回对应的toolName
- 通过Tool名字,从Tool注册表里获得对应的Tool实例
- 调用Tool的执行函数Swap(),会到solona链上执行对应的函数然后返回对应的执行结果
- 获取对应的执行结果
- 把执行结果嵌入在原来的Response Message里
- 将完整的Response Message返回给用户
 ResponseMessage2 {
 message:  购买成功
 }
2.3 从知识库里获取知识流程
用户继续把发送请求
RequestMessage3 {
	message: 帮我介绍下 Jupiter 的运行机制
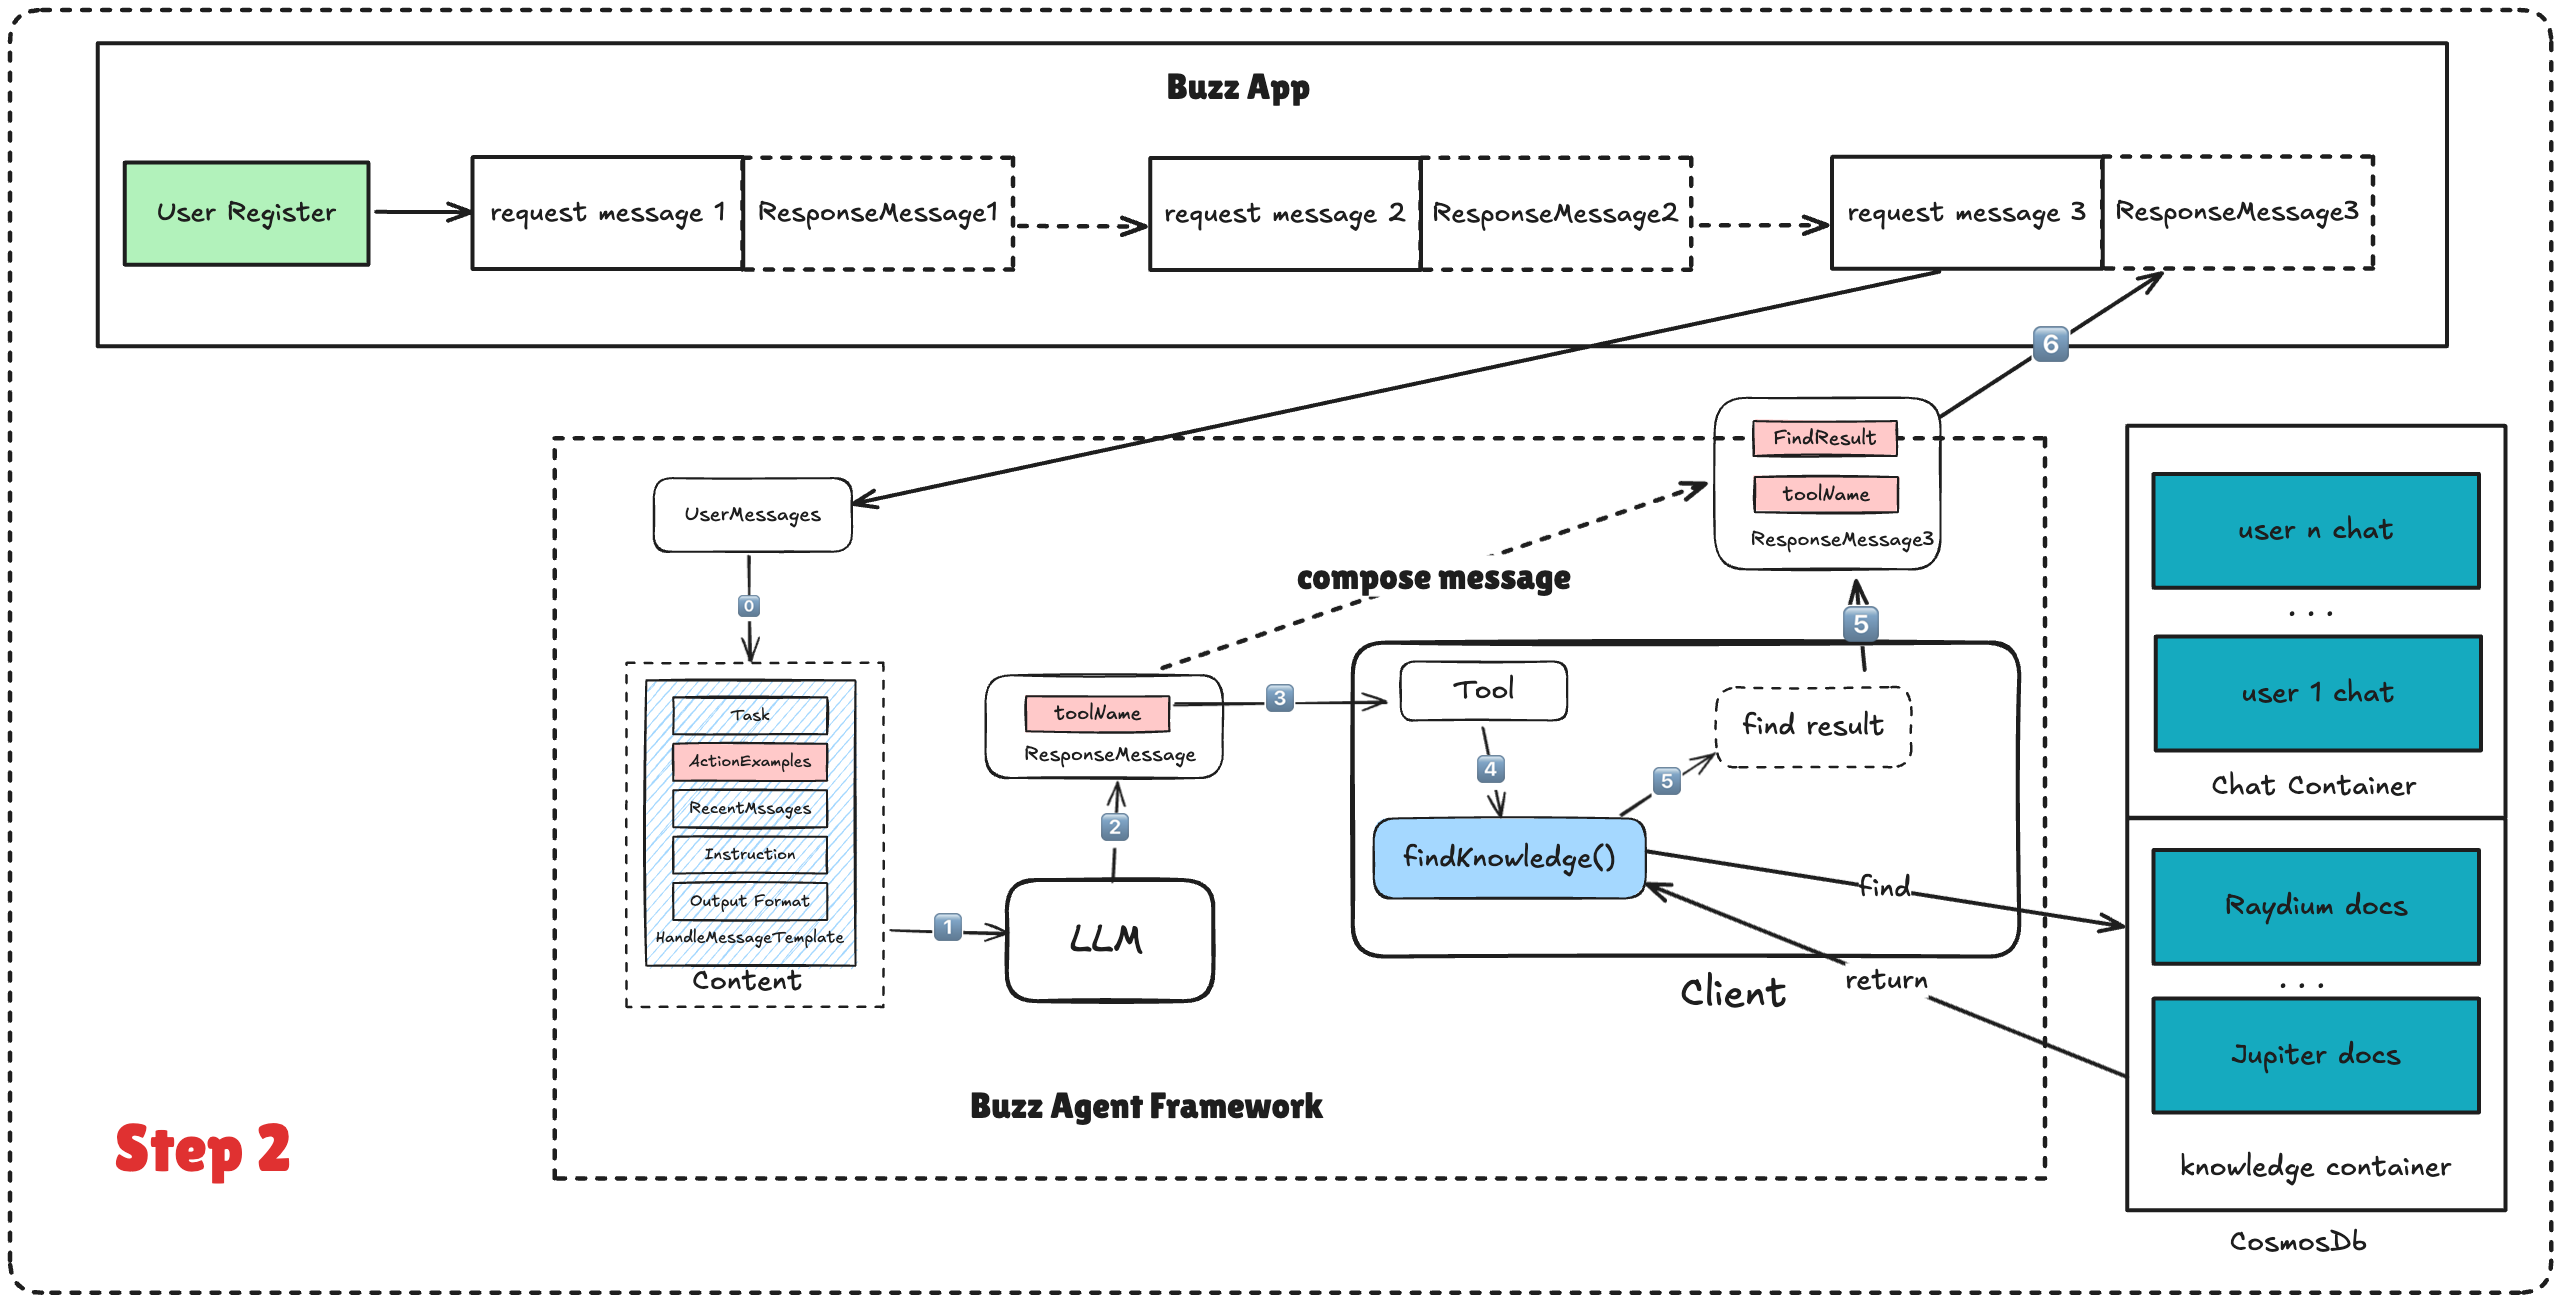
- 用户的信息仍然会被用实现准备好的Template组合成Content
- 请求 LLM
- LLM发现该请求需要调用到对应的Tool, 于是会返回在回复的信息里返回对应的toolName
- 通过Tool名字,从Tool注册表里获得对应的Tool实例
- 调用 Tool 的执行函数FindKnowledge(),会从数据库寻找对应在Buzz 启动的时候预注入的web3知识
- 获取对应的执行结果
- 把执行结果嵌入在原来的Response Message里
- 将完整的Response Message返回给用户
 ResponseMessage3:{
Message: Jupiter的运行机制如下:
...
...
...
 }
2.4 Buzz如何为每个用户开辟独立的存储区
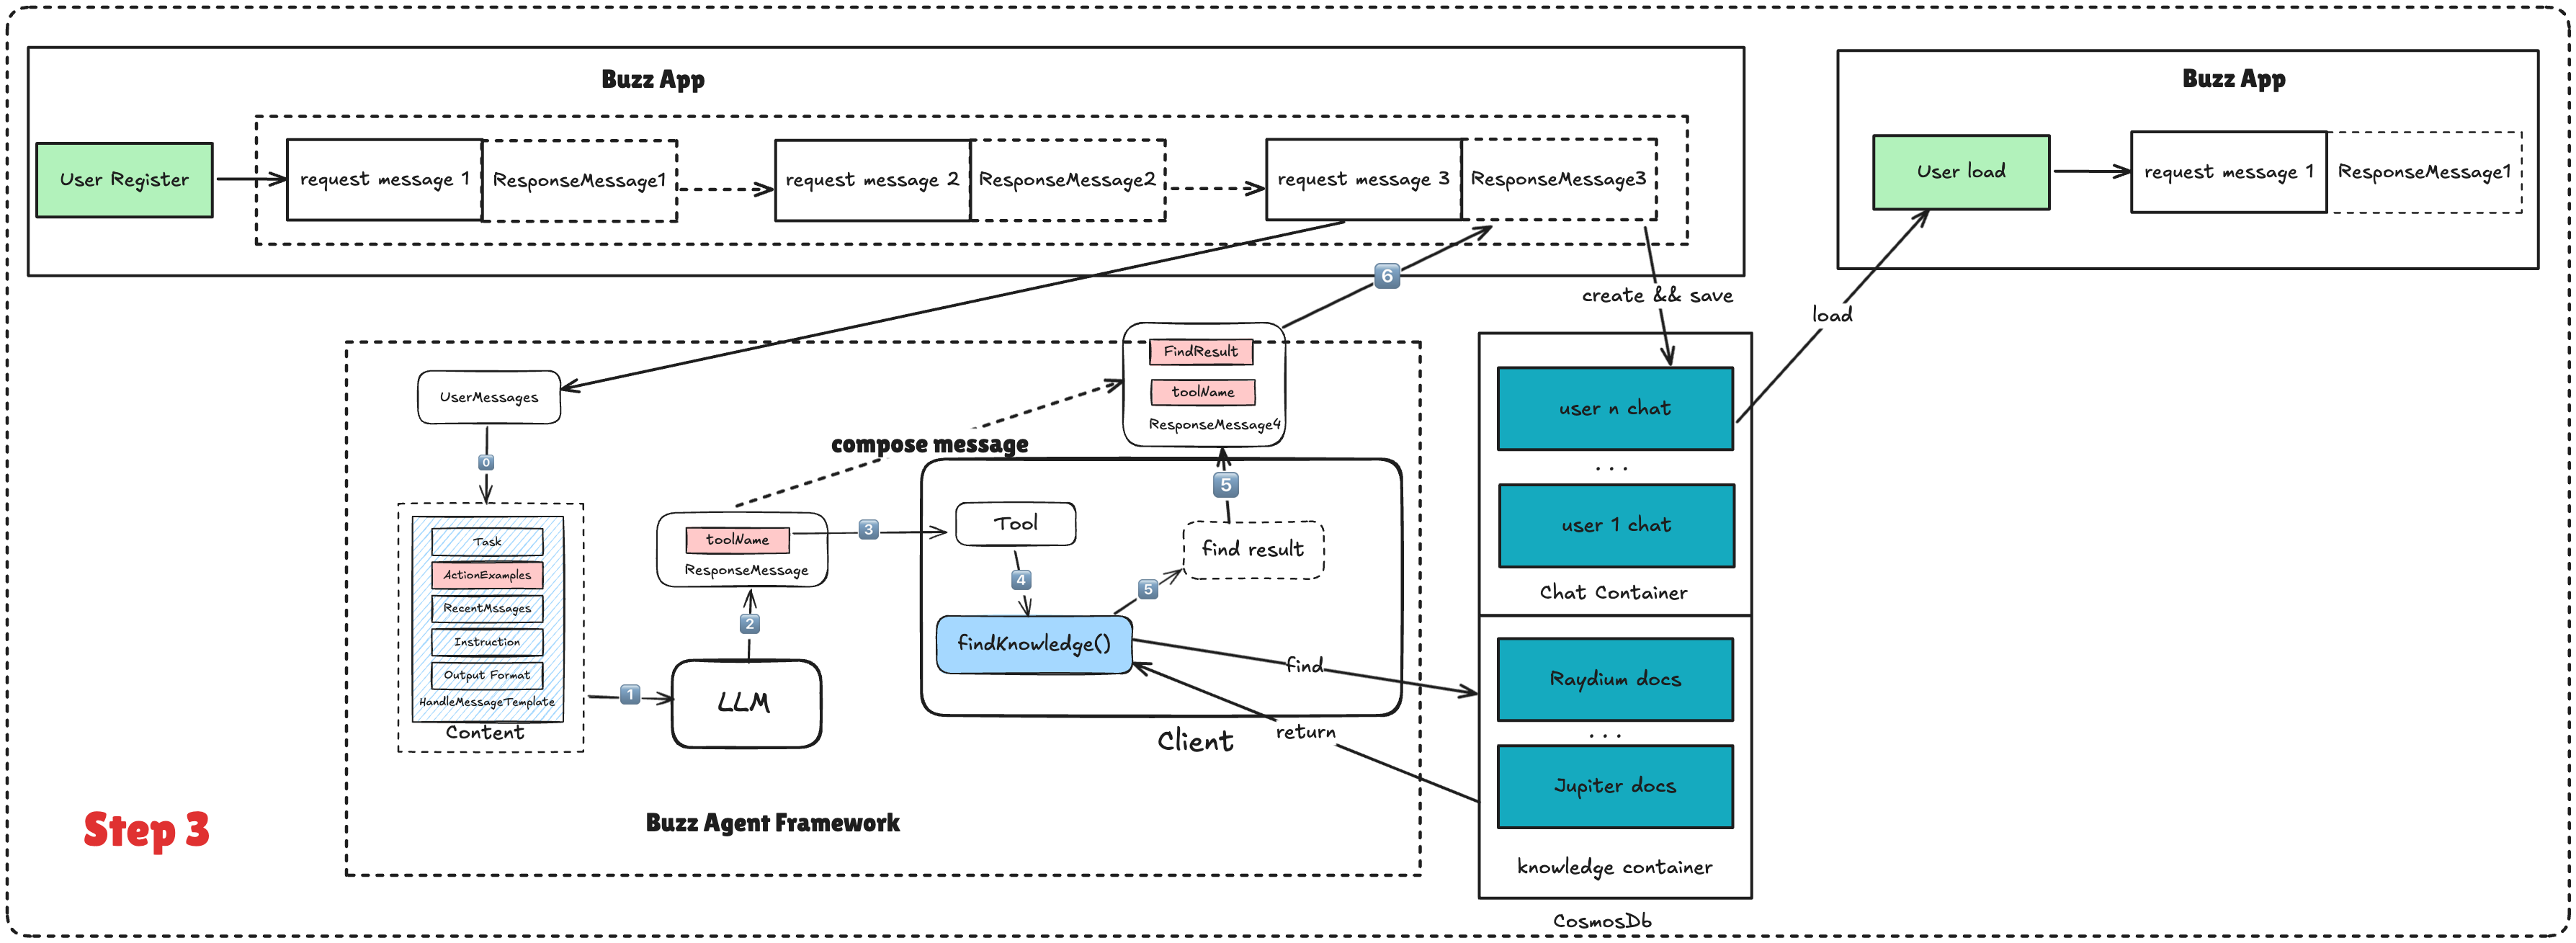 比如在上面的流程结束之后,用户退出了buzz app,那么Buzz会把这次聊天的内容按照如下处理:
- 用户第一次注册,为其该用户开辟专门的聊天分区
- 调用 OPENAI 生成这次聊天的 Summary
- 调用 OPENAI 把 Summary 转换成 Summary Vector
- 把对应的数据以 Summary Vector 作为key 存储到CosmosDB里
在下次用户下次登录的时候,CosmosDB会加载用户的历史数据,如果讨论的话题跟原来的记录有关会load这部分数据,从而创造独属于每个人的Web3 Agent。
关于CosmosDB处理knowledge的细节
- 这里我们来看看知识是怎么存储在CosmosDB数据库的:
调用时机:项目方在Buzz启动前提前存入的数据
存储流程:
- 根据给的请求Url爬取文档信息bn
- 处理爬取结果
- 请求openai ,让他对每个文档生成对应的summary
- 通过open-ai模型将 summary 转化成 summary vector
- 把 summary vector 作为key 把文档和summary一起存储到向量数据库cosmosDB中 ```typescript export const POST = async (req: NextRequest) => { // 1. 获取请求参数 const { url, name, includePaths, excludePaths, authCode } = await req.json();
// 2. 验证授权 if(authCode !== process.env.CRAWL_AUTH_CODE) { return NextResponse.json({ error: “Unauthorized” }, { status: 401 }); }
// 3. 爬取文档 const crawlResponse = await firecrawl.asyncCrawlUrl(url, { limit: 500, maxDepth: 10, includePaths, excludePaths });
// 4. 处理爬取结果 // …
// 5. 对每个文档进行处理 const knowledge = await Promise.all(docs.map(async (doc) => { if(!doc.markdown) { return; } // 生成摘要 const { text: summary } = await generateText({ model: openai(“gpt-4o-mini”), prompt:
Summarize the following documentation page in 1 sentence...})// 生成向量嵌入 const { embedding: summaryEmbedding } = await embed({ model: openai.embedding("text-embedding-3-small"), value: summary }) // 添加到知识库 const knowledgeInputs: KnowledgeInput[] = [{ baseUrl: url, name, url: doc.metadata?.url, title: doc.metadata?.title, description: doc.metadata?.description, favicon: doc.metadata?.favicon, markdown: doc.markdown, summary, summaryEmbedding }]; // 存储到数据库 for await (const knowledgeInput of knowledgeInputs) { await addKnowledge(knowledgeInput); } return true; })); } ``` - 从CosmosDB数据库中检索知识的流程:
调用时机: 用户的请求数据中触发
流程:
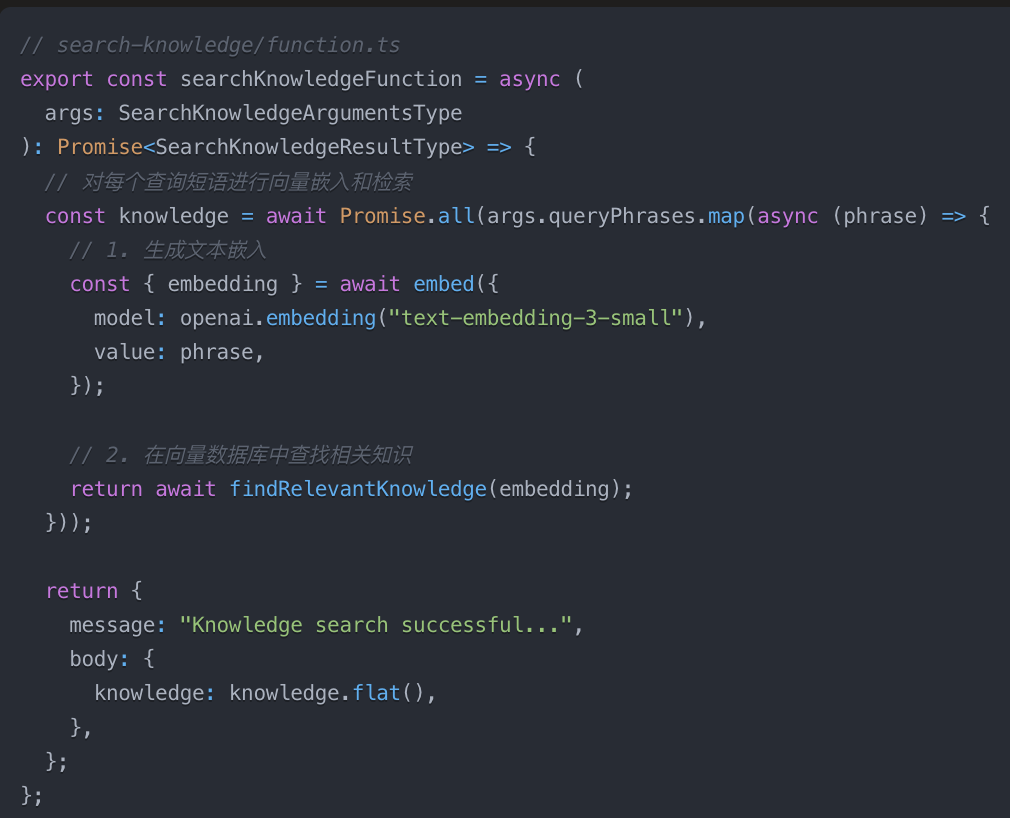
- 将查询短语进行向量化
- 在数据库中查询跟这个向量距离最近的向量
3. 最新的Swarms升级
Agents在昨天把自己从单一Agent的架构,转换成Agents的架构,执行逻辑类似我之前写的Swarm的BossAgent的架构,具体可以参考我写的Swarm原理解析(二) https://x.com/hhh69251498/status/1876190960360870215
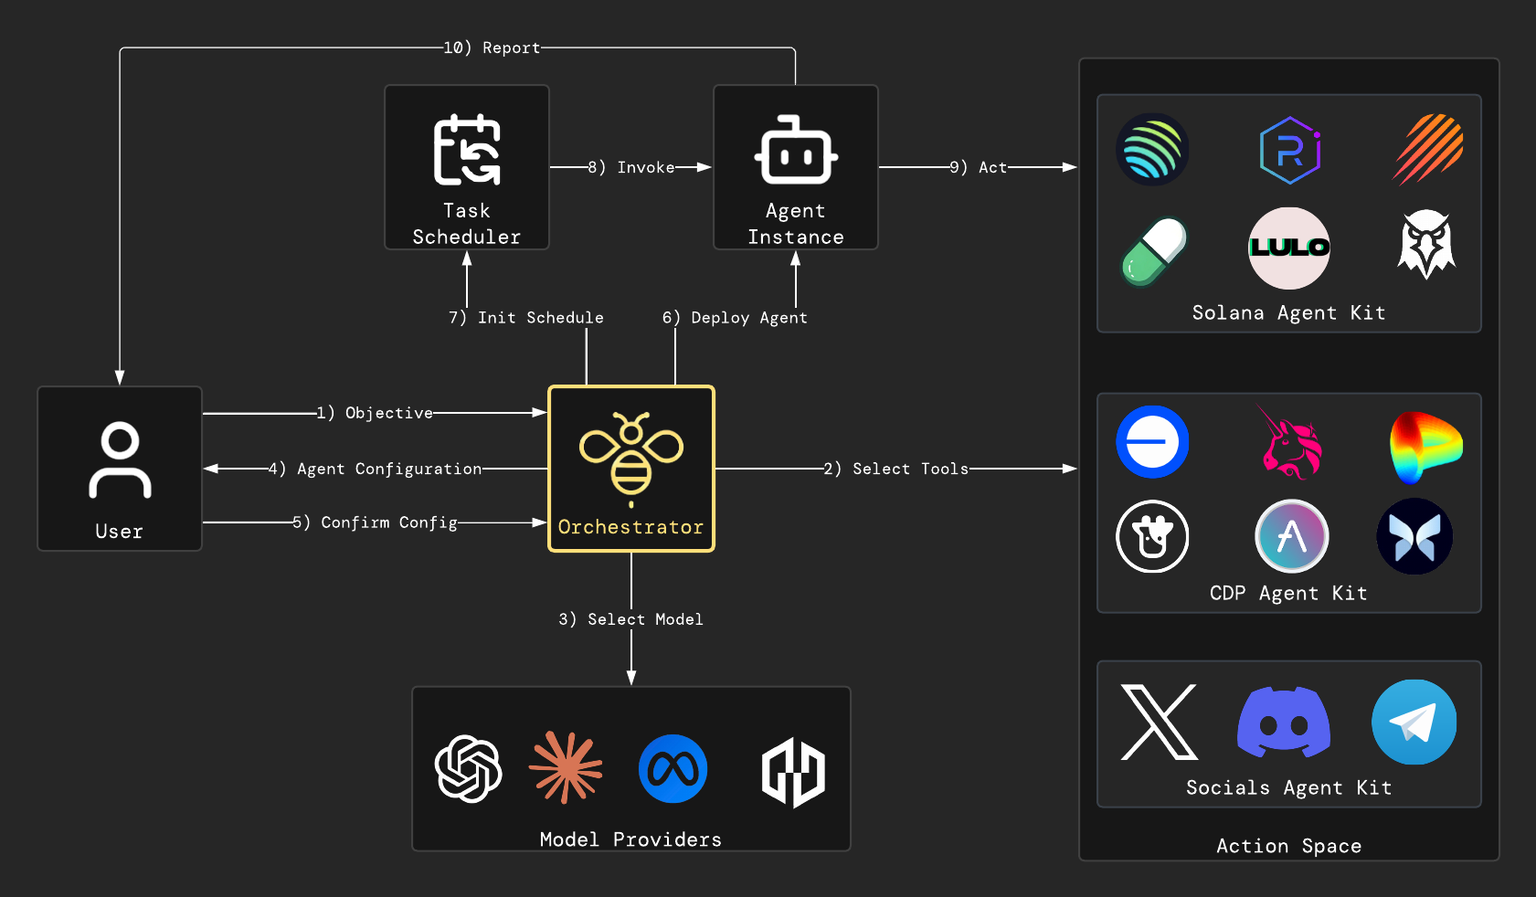 Swarm的好处在于,不同的Agent可以专门处理任务的一部分,因此可以进行并行;同时可以跳出Content长度的限制。
而且也就如我写的 Swarm架构的文章里总结的
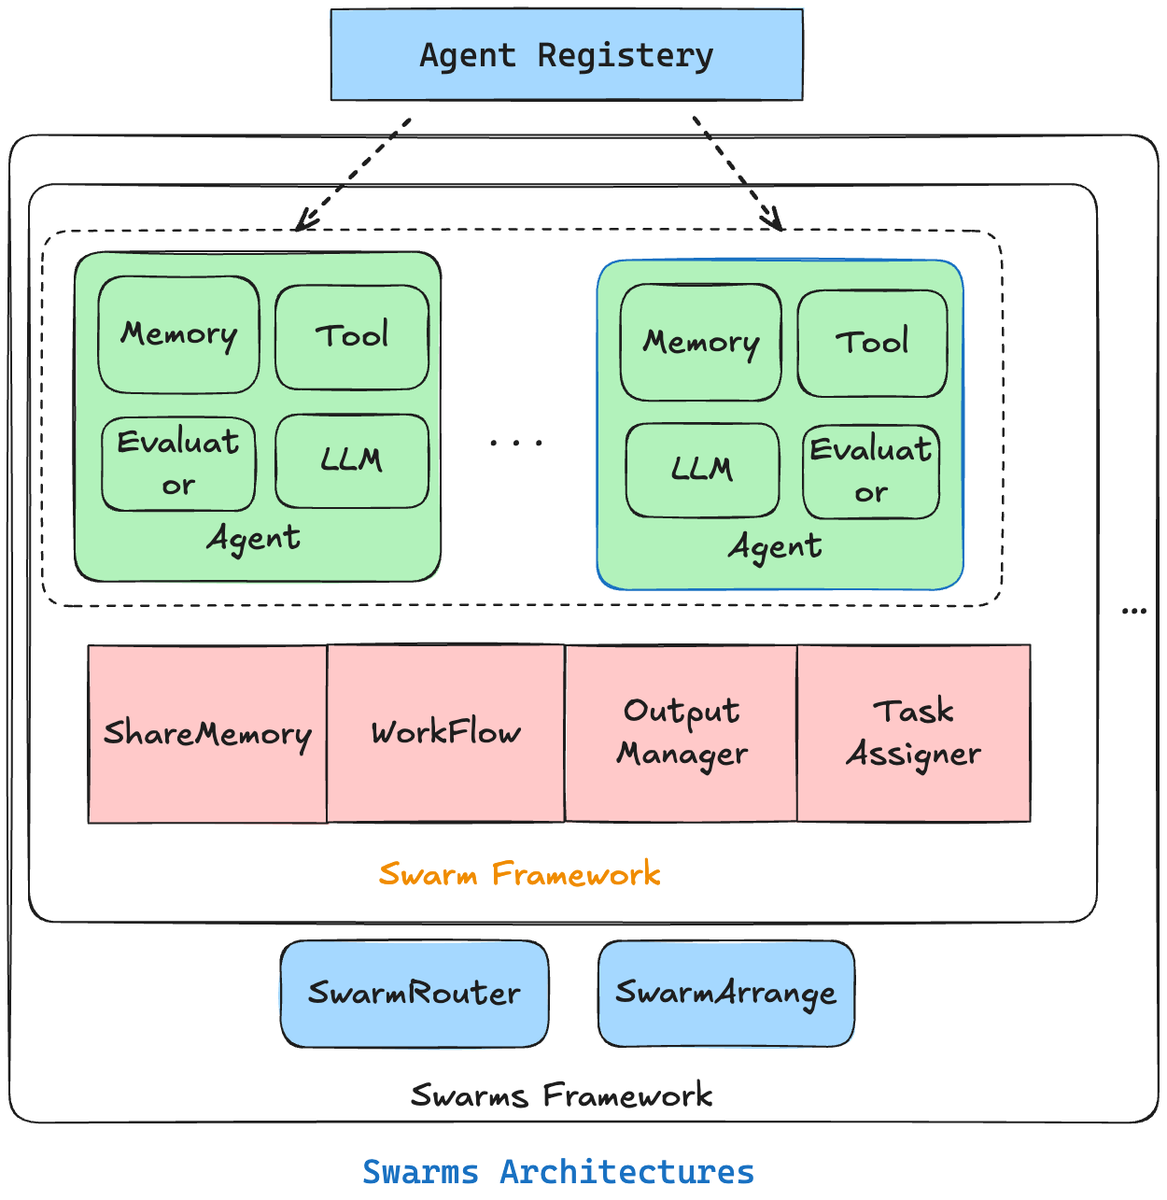 Swarm Framework这一层其实需要管理不同的组件ShareMemory, WorkFlow和 OutputManager, TaskAssigner ,我们会发现当协调多个Agent共同工作的时候
我们需要考虑以下几个问题:
- 决定任务交给谁做 (TaskAssigner)
- 怎么协调Agent参与工作的先后顺序 (WorkFlow)
- 怎么管理任务执行之后产生的输出(Output Manager)
- 异步执行的时候怎么传递一些状态给其他相关任务(ShareMemory)
而目前Buzz已经在OutputManager和TaskAssigner发力了,并且拥有很好的代码质量。
4. 总结
因此本质上来说:
- Buzz没有采用任何 Agent Framework 来写自己的代码,核心原因是大多数 Agent Framework代码确实一般,而且本身Agent Framework 并不存在太强的护城河(API 封装),更何况Buzz 的代码质量确实比 ElizaOS, zerebro 这些 Agent Framework 的代码质量强太多,目前在我看的 AI Agent里代码质量是最高的。
- Buzz的代码模块化得超级好,如果Buzz想做 Agent Framework,只需要把自己关于Agent的代码摘出来就行了,所以Agent Framework其实并不存在什么技术护城河;大家来看这一波真正起飞的Web3 Agent,会发现其实极少的项目去使用 Agent Framework. 而是自己写一套更适合自己业务的代码(也有可能是自己写的代码质量更好)
- Buzz通过预先的Web3知识导入实现了web3专属代理,但是还是期待这部分的工作可以转移到预训练的阶段来做。
- 通过为每个用户在Agent里开辟自己的内存区域,并且在用户下一次开启聊天的时候加载这部分memory,实现为每个用户创造独属于自己的web3 agent
- 是否能为每个用户启动一个自己的Agent,并且支持更好的定制化;这个很明显需要配合 1,以及通过多个Agents的协作让每个 Buzz 有能力根据用户的需求自动生成对应的tool.
- 对于大多数复杂的场景来说,单一Agent受限于Content的长度限制,以及响应速度跟成本的考量无法很好的完成人类给予的任务,这一点我自己在写一个代码分析Agent时也遇到了(画图),当仓库太大的时候,我们还是需要通过Swarm来处理。因为通过Swarm我们可以获得多个Agent并行处理任务,获得更大的Memory容量,以及跳出Content长度的限制等等,而且从人类社会发展史来看,协作一定是趋势。
- 当然最终 作为一个 Web3 Agent, 最核心的还是 Buzz 产品本身的使用体验,希望Buzz继续快速迭代,给用户提供更多的功能以及放开每个用户的请求次数限制。
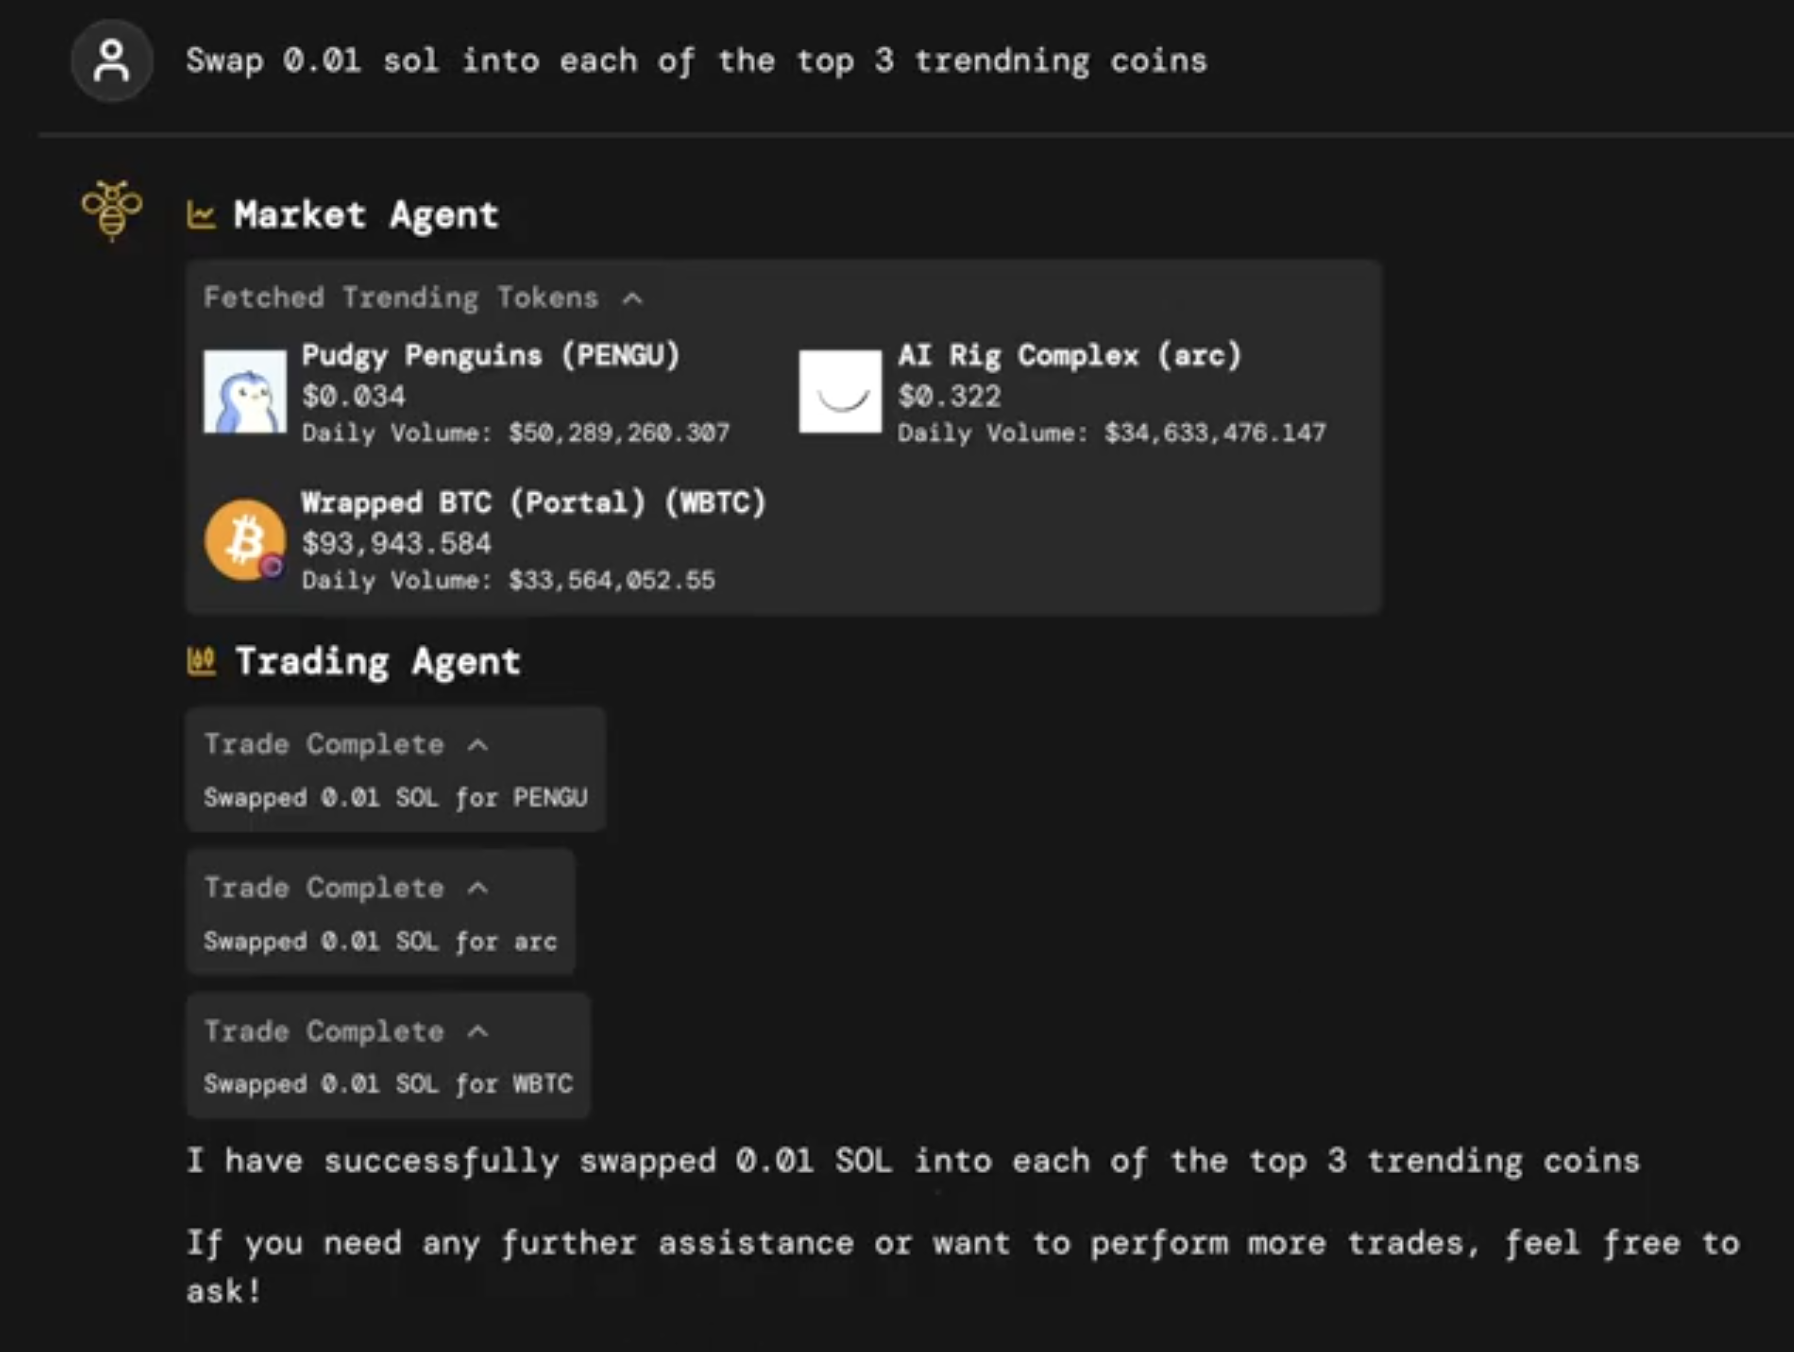
- Buzz目前的用户体验还不够好,还是会遇到类似的问题

- 另外一个很有趣的看法是,Agent发展路程一定是往Swarm去发展,但是人类中的超级个体却在通过Agent变得更加强大,强者越强,弱者越弱,比如 Buzz的代码(https://github.com/jasonhedman/the-hive)其实是solo写出来的,未来的人类路在何方呢?
5. 代码细节
1. 聊天内容存储到数据库的完整流程:
- 聊天存储触发时机
在 ChatProvider 中,当消息更新时会触发存储:
// app/(app)/chat/_contexts/chat.tsx
const ChatProvider = ({ children }) => {
    // 生成新的聊天ID
    const [chatId, setChatId] = useState<string>(generateId());

    // 监听消息变化
    useEffect(() => {
        const updateChat = async () => {
            // 只有当有消息且不在加载状态时才更新
            if(messages.length > 0 && !isLoading) {
                const response = await fetch(`/api/chats/${chatId}`, {
                    method: 'POST',
                    headers: {
                        Authorization: `Bearer ${await getAccessToken()}`,
                    },
                    body: JSON.stringify({
                        messages,
                    }),
                });
                const data = await response.json();
                if(typeof data === 'object') {
                    mutate(); // 触发客户端缓存更新
                }
            }
        };

        updateChat();
    }, [isLoading]);
}
- API 路由处理
在 api/chats/[chatId]/route.ts 中处理存储请求:
export const POST = async (req: NextRequest, { params }: { params: Promise<{ chatId: string }> }) => {
    const { chatId } = await params;
    const { messages } = await req.json();

    try {
        // 验证用户身份
        const authHeader = req.headers.get("authorization");
        const token = authHeader?.split(" ")[1];
        const { userId } = await privy.verifyAuthToken(token);

        // 获取已存在的聊天
        const chat = await getChat(chatId, userId);

        if(!chat) {
            // 如果是新聊天,创建新记录
            return NextResponse.json(await addChat({
                id: chatId,
                userId,
                messages,
                // 生成聊天标题
                tagline: await generateTagline(messages),
            }));
        } else {
            // 如果聊天存在,更新消息
            return NextResponse.json(
                await updateChatMessages(chatId, userId, messages)
            );
        }
    } catch (error) {
        console.error("Error in /api/chats/[chatId]:", error);
        return NextResponse.json(false, { status: 500 });
    }
}
- 数据库操作
在 db/services/chats.ts 中定义了具体的数据库操作:
// 添加新聊天
export const addChat = async (chat: Chat): Promise<Chat | null> => {
    return add<Chat, Chat>(await getChatsContainer(), chat);
};

// 更新聊天消息
export const updateChatMessages = async (
    id: Chat["id"],
    userId: Chat["userId"],
    messages: Message[]
): Promise<boolean> => {
    return update(
        await getChatsContainer(),
        id,
        userId,
        [{
            op: PatchOperationType.set,
            path: `/messages`,
            value: messages
        }]
    );
};

// 获取聊天记录
export const getChat = async (
    id: Chat["id"],
    userId: Chat["userId"]
): Promise<Chat | null> => {
    return get(await getChatsContainer(), id, userId);
};
- Cosmos DB 容器配置
在 db/containers/chats.ts 中配置了聊天容器:
export const CHATS_CONTAINER_ID = "chats";

let chatsContainer: Container;

export const getChatsContainer = async () => {
    if (!chatsContainer) {
        chatsContainer = await getContainer<Chat>(
            CHATS_CONTAINER_ID,
            "userId"  // 使用 userId 作为分区键
        );
    }
    return chatsContainer;
};
- 聊天数据类型定义
在 db/types/chat.ts 中定义了数据结构:
export type Chat = {
    id: string;          // 聊天ID
    messages: Message[]; // 消息数组
    tagline: string;    // 聊天标题
    userId: string;     // 用户ID
}
- 标题生成
为了更好的组织聊天记录,系统会自动生成标题:
const generateTagline = async (messages: Message[]) => {
    const { text } = await generateText({
        model: openai("gpt-4o-mini"),
        messages: [
            messages[0],
            {
                role: "user",
                content: "Generate a 3-5 word description of the chat..."
            },
        ],
    });

    return text;
}
这个完整的流程确保了:
- 聊天内容实时保存
- 用户身份验证
- 数据安全性
- 聊天检索和组织
- 错误处理和恢复
使得用户可以在任何时候恢复之前的对话,并保持聊天历史的完整性。
2. 对于 Knowledge的处理,则是按照以下流程处理
SearchKnowledgeAction 是在 AI 需要检索特定协议或概念的详细信息时被调用的。让我分析其调用流程:
- 定义和注册:
// knowledge/actions/search-knowledge/function.ts export const searchKnowledgeFunction = async (args: SearchKnowledgeArgumentsType) => { const knowledge = await Promise.all(args.queryPhrases.map(async (phrase) => { // 转换查询为向量 const { embedding } = await embed({ model: openai.embedding("text-embedding-3-small"), value: phrase, }); // 在知识库中搜索 return await findRelevantKnowledge(embedding); })); return { message: "Knowledge search successful...", body: { knowledge: knowledge.flat(), }, }; }; - 调用场景:
当用户询问:
- 特定协议的工作原理(如”Jupiter 交易聚合是如何工作的?”)
- 具体概念的解释(如”什么是 SOL 质押?”)
- 技术细节(如”如何使用 Lulo 借贷?”)
- 实际调用过程:
// api/chat/solana/route.ts const stream = streamText({ model, tools: { ...solanaTools(connection), ...twitterTools(twitterApi), // 注册知识搜索工具 ...knowledgeTools() }, messages, // 系统提示会指导 AI 在需要详细协议知识时使用此工具 system: "You are a swarm of helpful blockchain agents..." }); - 使用示例: 用户: “解释下 Jupiter 的 DEX 聚合器是如何工作的?”
AI 会:
- 识别需要协议知识
- 调用 SearchKnowledgeAction:
{ toolName: "search-knowledge", args: { queryPhrases: ["Jupiter DEX aggregator working mechanism"] } } - 返回结果处理:
// knowledge/actions/search-knowledge/search-knowledge.tsx const SearchKnowledge: React.FC<Props> = ({ tool }) => { return ( <ToolCard tool={tool} agentName="Knowledge Agent" icon="Brain" loadingText={`Searching Knowledge...`} resultHeading={(result) => `Searched knowledge base`} resultBody={(result) => `Included the top ${result.body.knowledge.length} pages in context.` } defaultOpen={false} /> ) } - 知识使用:
AI 会利用搜索到的知识来提供准确的回答:
- 整合多个文档的信息
- 提供具体的技术细节
- 引用官方文档的说明
- 但是还有一个问题是知识是什么时候被存储进去的
crawl-docsAPI 是一个用于抓取文档内容并将其添加到知识库的端点。这个端点不是在普通用户对话过程中调用的,而是在系统初始化或更新文档时由管理员主动调用的。
让我们看看它的具体实现:
export const POST = async (req: NextRequest) => {
    // 1. 获取请求参数
    const { url, name, includePaths, excludePaths, authCode } = await req.json();

    // 2. 验证授权
    if(authCode !== process.env.CRAWL_AUTH_CODE) {
        return NextResponse.json({ error: "Unauthorized" }, { status: 401 });
    }

    // 3. 爬取文档
    const crawlResponse = await firecrawl.asyncCrawlUrl(url, {
        limit: 500,
        maxDepth: 10,
        includePaths,
        excludePaths
    });

    // 4. 处理爬取结果
    // ...

    // 5. 对每个文档进行处理
    const knowledge = await Promise.all(docs.map(async (doc) => {
        if(!doc.markdown) {
            return;
        }
        // 生成摘要
        const { text: summary } = await generateText({
            model: openai("gpt-4o-mini"),
            prompt: `Summarize the following documentation page in 1 sentence...`
        })

        // 生成向量嵌入
        const { embedding: summaryEmbedding } = await embed({
            model: openai.embedding("text-embedding-3-small"),
            value: summary
        })

        // 添加到知识库
        const knowledgeInputs: KnowledgeInput[] = [{
            baseUrl: url,
            name,
            url: doc.metadata?.url,
            title: doc.metadata?.title,
            description: doc.metadata?.description,
            favicon: doc.metadata?.favicon,
            markdown: doc.markdown,
            summary,
            summaryEmbedding
        }];

        // 存储到数据库
        for await (const knowledgeInput of knowledgeInputs) {
            await addKnowledge(knowledgeInput);
        }
        return true;
    }));
}
这个 API 的主要使用场景是:
- 初始化知识库:
- 当系统首次部署时
- 当需要添加新的协议或项目文档时
- 更新文档:
- 当文档内容有重大更新时
- 当需要添加新的文档章节时
- 维护知识库:
- 定期更新现有文档
- 添加新的文档来源
可以看到
SEARCH_KNOWLEDGE_PROMPT中提到的文档范围: ```typescript export const SEARCH_KNOWLEDGE_PROMPT = `This tool searches a vector database that is filled with information about blockchain protocols and concepts.
Documents cover:
- Solana docs
- Jupiter docs and guides
- Raydium docs
- DexScreener docs
- Meteora docs
- Orca docs
- Jito docs
- Kamino docs
- Lulo docs
这些文档都是通过 crawl-docs API 预先抓取并存储的,这样当用户在对话中询问相关问题时,AI 就可以通过 search-knowledge action 快速检索相关信息。
使用方式示例:
curl -X POST http://your-api/api/crawl-docs \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://docs.jupiter.xyz",
    "name": "Jupiter Documentation",
    "includePaths": ["/docs"],
    "excludePaths": ["/blog"],
    "authCode": "your-auth-code"
  }'
这种设计允许系统维护一个高质量的知识库,同时确保只有授权用户才能更新文档内容。当用户在对话中需要这些信息时,AI 可以快速准确地提供相关答案。 总之,SearchKnowledgeAction 是 AI 的知识增强工具,使其能够提供准确、最新的协议信息。它在 AI 需要深入的技术细节或具体实现说明时自动被调用。