Swarms 架构
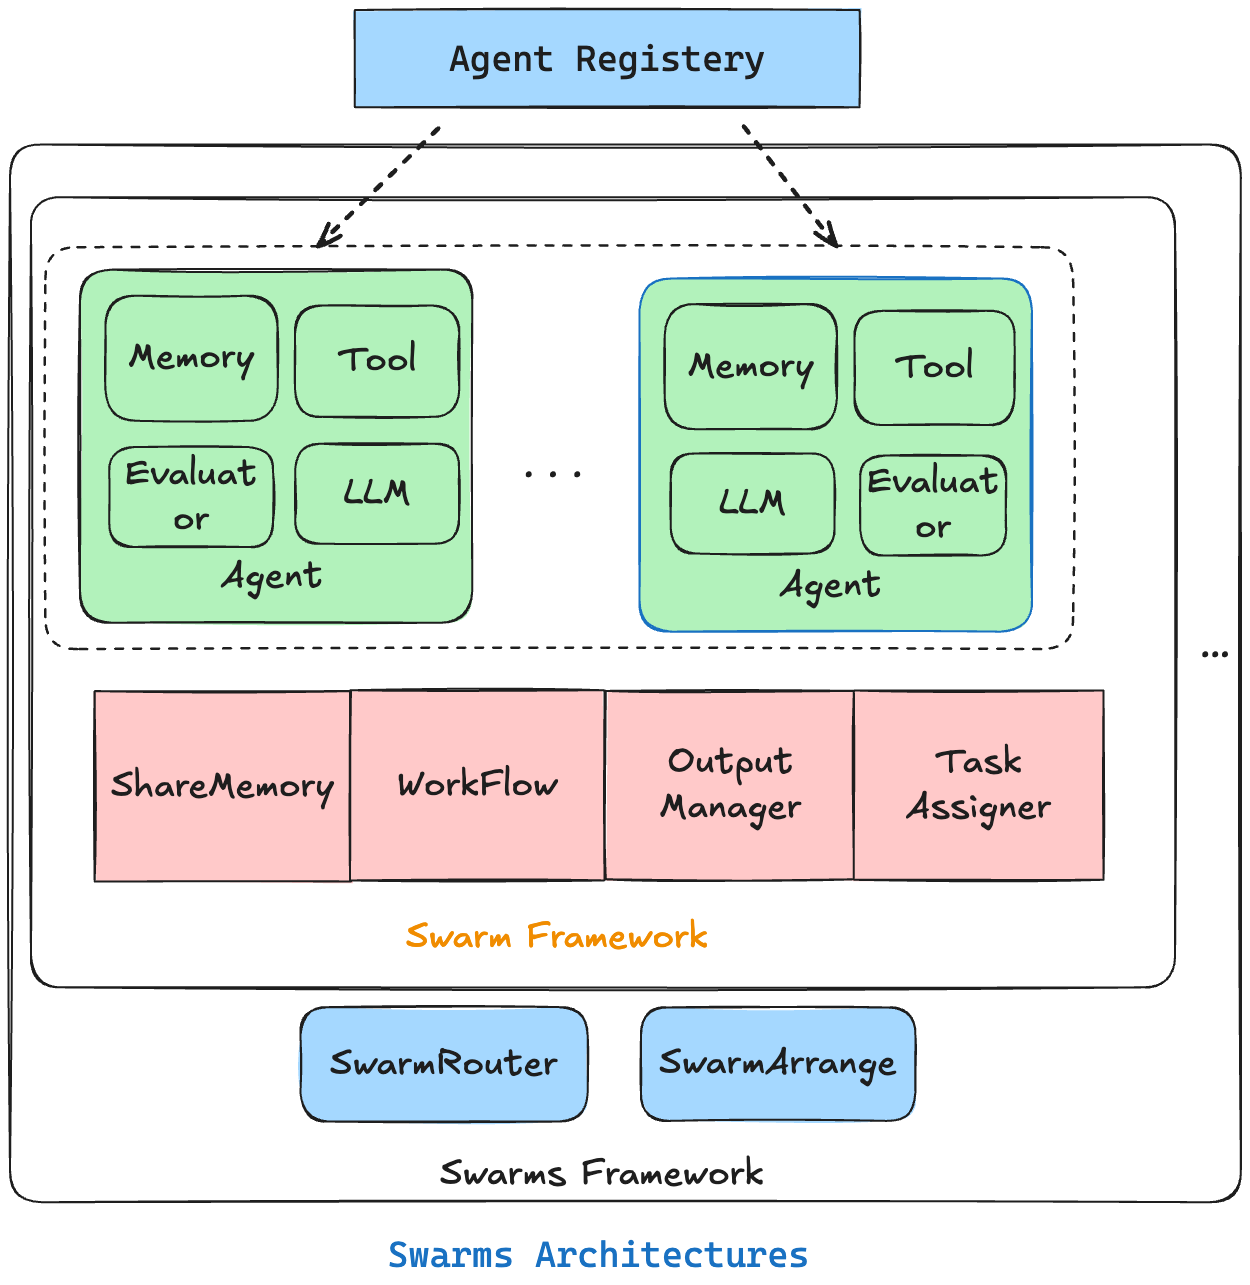
- Swarms的Agent的设计该有的功能都有,也就是跟ElizaOs一样都支持了Memory,Tool,LLM,Evaluator, 同时Tool的设计上也都是采用对应了对应的注册表的方式
- 在Agent之上是对应的Swarm Framework,用于协调多个Agent之间的工作
- 目前Swarms已经实现的Swarm Framework有:
- MajorityVoting,相当于多个不同的Agent同时执行一个task,最后会通过投票的方式选择一个最佳答案进行回复,最多得票数的回复会被采用;其实也很想区块链的Pos共识机制,挺有趣的
- AgentRearrange,是一个很灵活的Swarm框架,比如我们现在有三个不同的Agent A,B,C,D ; 然后假设有一个任务希望 按照 task -> A -> B -> C -> D的方式被处理,即A先处理这个任务然后交给B处理再给C处理接着给D处理,那么我们只需要在WorkFlow里这么定义 workflow = “ A -> B -> C -> D”, 然后初始化这个AgentRearrange并且运行,如下所示:
AgentRearrange(agents = [A,B,C,D],workflow = " A -> B -> C -> D").run(task)我们就可以拿到按照我们规定的工作方式最后产生的结果 - 同时如果我们把WorkFlow定义成 A -> B,C -> D,那么A执行task之后,B、C会同时执行任务,最后D再执行任务,所以这是一个可以通过WorkFlow实现灵活定义整个工作流的Swarm模式 - GraphFlow,则相比AgentRearrange还有支持更复杂的工作流关系,可以任意设计整个工作流的之间的依赖关系 - GroupChat 则是让多个Agent进行多轮对话,最终通过多轮对话不断完善要完成的任务内容,从而让结果更可靠更详尽 - - MixtureOfAgents 则是多个Agent同时工作,最后有一个Agent负责总结所有的工作,并产生最终的输出 - RoundRobin则是通过轮询的方式让每个Agent平等的参加工作 - ForestSwarm则是可以支持多个层级的Agent关系,所以就想树有很多枝干一样,ForestSwarm就是一个巨大的Agent节点构成的网络,因为起名叫做森林 - 还有MultiAgentRouter也是我们介绍过的BossAgent - ConcurrentWorkflow,支持多个AI Agent同时执行同一个任务 - AsyncWorkflow, 多个AI Agent异步执行任务,因此这里需要用到ShareMemory来记录任务产生的数据,同时还有复杂的SpeakSystem- 所以Swarm Framework这一层其实需要管理不同的组件,ShareMemory, WorkFlow和 OutputManager, TaskAssigner ,因为总结上面这些不同的Swarm Model,我们会发现当我们想协调多个Agent共同工作的时候我们需要考虑以下几个问题: 1. 决定任务交给谁做 (TaskAssigner) 2. 怎么协调Agent参与工作的先后顺序 (WorkFlow) 3. 怎么管理任务执行之后产生的输出(Output Manager) 4. 异步执行的时候怎么传递一些状态给其他相关任务(ShareMemory)
- Swarm再上层就是Swarms Framework了,用于协调多个Swarm之间的工作,目前主要支持两种
- SwarmRouter
- 通过 「Word Vector」比较的方式选择最合适的Swarm Model进行执行task
- SwarmRearrange
- 也可以通过类似定义 workflow 的方式,直接协调多个 Swarm 进行工作
- SwarmRouter
- 最后我想再强调一下一个Agent是可以在不同的Swarm下直接工作的,所以这里所有的Agent都会由AgentRegistry进行管理,从而能在不同Swarm下尽可能多的复用。
最终Swarms产生的结果就是,任何Agent协作场景你都能在Swarms上找到开箱即用的协作方式,而即便是更复杂的场景也可以通过不同Swarms之间的配合来实现,因此相比ElizaOS而言,我觉得Swarms对Agent 领域的贡献要大得多,当然现在的代码还不是完美状态,但是很明显随着越来越多开发者来到Swarms生态我们可以一起把这些很前沿的代码Build到最好
目前Swarms生态也开始起来,我觉得会爆发出巨大的力量,就比如 Swarms 生态的龙一MCS 的核心代码不过百来行,核心是通过 AgentRearrange的Swarm Model协调四个agent之间的工作,而且当时Kye搞MCS核心的目的就是想证明Swarms行!
- 核心架构与Agent:
主要Agent:
- 首席医疗官(Chief Medical Officer):协调整个团队,收集症状,形成鉴别诊断
- 医疗编码员(Medical Coder):分配 ICD-10 代码,确保编码合规
- 诊断合成器(Synthesizer):整合所有发现生成最终诊断评估
- 治疗智能体(Treatment Agent):根据效果和成本推荐治疗方案
- 实验室匹配器(Lab Matcher):匹配诊断与实验室检查,提供参考范围
定义Workflow:
首席医疗官 -> 医疗编码员 -> 诊断合成器 -> 治疗智能体
- 协调机制: 并通过上面介绍的AgentRearrange 方式来实现协调多个Agent工作
- 工作流程
def run(self, task: str):
 # 1. 准备任务信息
 case_info = {
     "patient_id": self.patient_id,
     "timestamp": datetime.now(),
     "patient_documentation": self.patient_documentation,
     "task": task
 }

 # 2. 加密任务信息
 encrypted_case = self.secure_handler.encrypt_data(case_info)

 # 3. 解密用于处理
 decrypted_case = self.secure_handler.decrypt_data(encrypted_case)

 # 4. 执行智能体流程
 output = self.diagnosis_system.run(decrypted_case)

 # 5. 加密输出结果
 encrypted_output = self.secure_handler.encrypt_data(output)

 # 6. 解密输出供内部使用
 decrypted_output = self.secure_handler.decrypt_data(encrypted_output)

 # 7. 保存病人数据
 self.save_patient_data(self.patient_id, encrypted_output)
同时每轮执行前会从数据库中拿取该任务所需要的对应数据
class MedicalCoderSwarm:
    def memory_query(self, task: str):
        if self.long_term_memory:
            # 在记忆库中查询相关信息
            memory_retrieval = self.long_term_memory.query(task)

            # 添加到短期记忆
            self.short_memory.add(
                role="Database",
                content=f"Documents Available: {memory_retrieval}"
            )

    def _run(self, task: str):
        # 每轮执行前查询知识库
        if self.rag_every_loop:
            self.memory_query(task)

        # 执行智能体流程
        response = self.diagnosis_system.run(task)